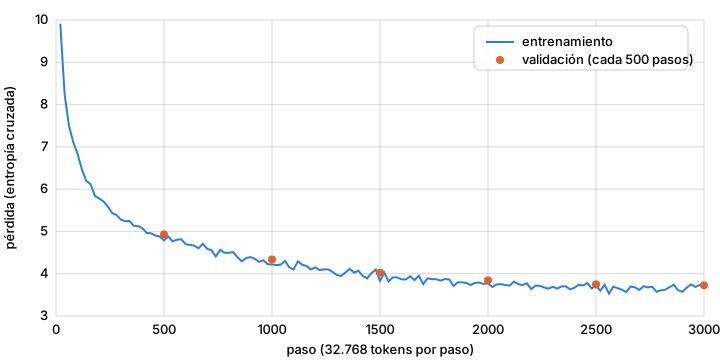
Desde el tercer ensayo anotamos que el modelo propio escribía español correcto pero no seguía el texto que le dábamos: empezaba otro tema. La sospecha era el empaquetado de documentos. Era otra cosa, y más tonta.
Qué pasaba
El tokenizador, al convertir un texto en tokens, añadía por defecto una marca de inicio delante y otra de fin de documento detrás. Durante el entrenamiento los documentos iban separados solo por la marca de fin, y la de inicio no aparecía nunca. Así que cuando le pedíamos continuar «La Constitución española establece que», el modelo veía «…establece que» + fin de documento, y hacía lo único razonable: empezar un documento nuevo.
Misma semilla, mismo modelo (v4), solo cambia cómo se codifica la entrada:
| Entrada | Con la marca de fin (antes) | Sin ella (ahora) |
|---|
| La Constitución española establece que | «C.E. de C.V. es la empresa responsable del tratamiento…» | «el Estado tiene competencia exclusiva sobre la materia de seguridad pública…» |
| El Ayuntamiento de Murcia ha aprobado | «Científicos de la Universidad Nacional de Educación a Distancia…» | «una nueva orden de gestión de los expedientes de contratación…» |
El modelo era mejor de lo que parecía: el fallo estaba en la entrada, no en los pesos.
Corrección
- El tokenizador ya solo añade la marca de inicio.
- Desde el quinto ensayo, cada documento de entrenamiento va como inicio + texto + fin, igual que se le presentará al generar.
- La evaluación ya no duplica la marca de inicio cuando usa la plantilla de chat.
Quinto ensayo: los datos eran el límite
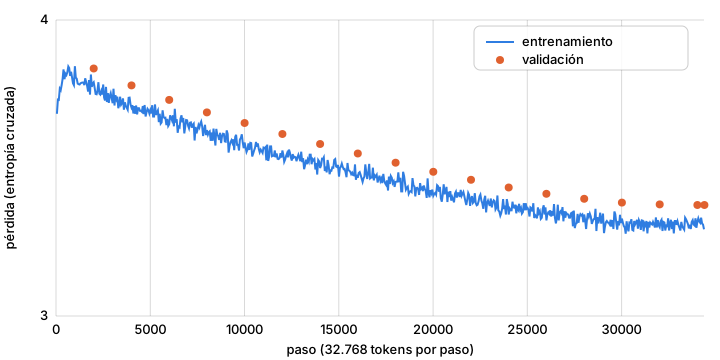
El cuarto ensayo dejó claro que con 207 millones de tokens el modelo de 112 millones de parámetros estaba cerca de su techo. Para el quinto hemos descargado en el servidor 1,27 millones de documentos nuevos de FineWeb-2 en español en 19 minutos, descartando los que ya teníamos (un 1,6 % coincidía con el corpus anterior). Con el BOE y el corpus anterior, el entrenamiento tiene 1.126 millones de tokens en 1,48 millones de documentos: 5,4 veces más que el cuarto ensayo.
Para que quepa, los tokens se guardan ahora en un fichero binario de 2 bytes por token en lugar de la caché de listas de 8 bytes que usábamos: 2,25 GB en vez de unos 20. Tokenizar todo llevó 10 minutos.
El ensayo parte de los pesos del v4 y recorre el corpus completo una vez: 34.372 pasos a 1,31 segundos, unas 12,5 horas en la L4 y unos 10 € de GPU. Empezó a las 02:50 y el servidor se apaga solo al terminar. La curva y las muestras están en la entrada siguiente. Mientras entrena, el motor de inferencia está parado para dejarle la GPU, así que la consulta pública de normativa no responde hasta entonces.
Lo que salió mal por el camino
- El disco de datos del servidor estaba al 100 % (202 MB libres) al encenderlo, con la base de datos del portal y el índice vectorial dentro. Lo hemos liberado borrando cachés regenerables y los puntos de control intermedios del v4 (su versión final está guardada en dos sitios). Queda vigilar el disco antes de cada ensayo. Lo vigilamos y, a las tres horas de entrenamiento, volvía a estar al 98 %: la copia de seguridad nocturna guarda cada día una instantánea de 2 GB del índice del BOE y las conservaba siete días en ese mismo disco. Ahora solo guarda las dos últimas, y se salta la instantánea si queda poco espacio.
- La primera prueba local del entrenamiento se quedó sin memoria en la GPU del portátil porque una sustitución en la configuración no se aplicó: probábamos con el lote de la nube, no con el del portátil.
También hoy
- Citas con título. La consulta pública de normativa citaba «BOE-A-2026-17836». Ahora cita «Ley 8/2026, de 2 de julio, de la erradicación del amianto» con el enlace al BOE. Los títulos de las 10.188 disposiciones ya indexadas se han añadido sin recalcular los embeddings.
- La web en móvil. El diario se desbordaba en pantallas de 375 píxeles (la página medía 440): la rejilla crecía hasta el ancho de la tabla más larga. Corregido.