Quinto ensayo terminado: con 5,4 veces más datos, el modelo propio mejora un tercio en texto que no ha visto
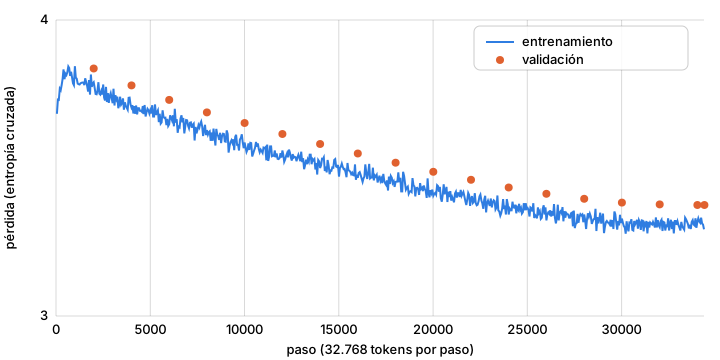
El quinto ensayo del modelo propio (112 millones de parámetros) ha terminado a las 15:45. Ha recorrido una vez los 1.126 millones de tokens del corpus ampliado, partiendo de los pesos del cuarto: 34.372 pasos en 12,9 horas de la L4, unos 10 € de GPU. El servidor se apagó solo al terminar y el modelo está copiado en dos sitios.
Cómo medirlo sin engañarnos
La pérdida de validación final es 3,375, peor en apariencia que el 3,07 del cuarto ensayo. No son comparables. Cada ensayo se valida con una parte de su propio corpus, y el del quinto incluye ahora mucho texto web de FineWeb-2, más variado y difícil de predecir que el BOE que dominaba antes.
Para comparar de verdad, medimos los dos modelos sobre el mismo texto, unos 30.000 caracteres de Wikipedia en español que ninguno de los dos ha visto:
| Modelo | Tokens de entrenamiento | Perplejidad en texto no visto |
|---|---|---|
| v4 | 207 M (dos épocas) | 41,4 |
| v5 | 1.126 M (una época más) | 27,2 |
Un 34 % menos de perplejidad. El 21,6 que publicamos del cuarto ensayo era sobre su propia validación, parecida a lo que había entrenado. Sobre texto nuevo, el v4 estaba bastante peor de lo que parecía. Era justo lo que sospechábamos: el límite eran los datos.
Qué escribe
Las mismas seis frases de arranque, con la misma semilla. El informe completo está en el repositorio (docs/evaluaciones/2026-11-04-v4-vs-v5.md).
| Arranque | v4 | v5 |
|---|---|---|
| Para preparar una buena paella hay que… | «poner un buen plato de pescado, la carne de cerdo y los huevos… te recomiendo que veas: 1. El queso parmesano» | «poner en el plato las verduras, la carne y los huevos. En un recipiente aparte hay que añadir agua…» |
| La inteligencia artificial puede ayudar a las pequeñas empresas a… | «desarrollar una cultura de la información que no tiene una función real…» | «desarrollar una mejor forma de hacer que la experiencia de los empleados sea más agradable.» |
El v5 se mantiene más en el tema y escribe frases más naturales, sobre todo fuera del lenguaje jurídico. Pero sigue inventando con total seguridad: un pleno municipal con «grupos parlamentarios de Ciudadanos y Vox (Cs)», o un edificio de Buenos Aires con «una estatua de un guerrero alemán». Es lo esperable en un modelo base de este tamaño. Sabe cómo suena el español, pero no tiene conocimiento fiable ni sigue instrucciones. No es un producto ni lo pretende: es la prueba de que el código, el tokenizador y los datos funcionan antes de gastar en un modelo grande.
Lo que sale mal
- La curva de validación se aplana al final (3,377, 3,375, 3,375) porque la tasa de aprendizaje baja a cero; no es que el modelo haya tocado techo. Con más datos y más parámetros seguiría bajando.
- Durante las 13 horas la consulta pública de normativa no respondió, porque la GPU estaba entrenando. Con un solo servidor, entrenar y servir a la vez no es posible.
Siguiente
El siguiente paso útil es un modelo de unos 1.000 millones de parámetros con unos 40.000 millones de tokens. En nuestra L4 tardaría unos 160 días. Estamos estudiando cómo pedir horas en los superordenadores europeos, que las dan gratis a pymes y startups a cambio de publicar los resultados.
modelopreentrenamientodatosmedidas